확인일: 2026년 9월 30일. 대상: 직접 API를 사용하는 개발자. 공식 요금표의 표준 처리·짧은 문맥 구간을 기준으로 설명하며, 구독형 ChatGPT·Claude 이용료와는 다른 계산입니다.
먼저 가격표의 네 칸을 보세요
기본 입력, 캐시 읽기, 캐시 쓰기, 출력을 구분합니다. 같은 토큰을 기본 입력 비용과 캐시 쓰기 비용에 이중으로 넣지 않도록 사용량 필드의 의미도 확인해야 합니다.
| 모델 | 기본 입력 | 캐시 읽기 | 캐시 쓰기 | 출력 |
| GPT-6.1 Sol | $2.00 | $0.10 | $2.50 | $10.00 |
| Claude Sonnet 5.5 | $2.00 | $0.20 | $2.50 / $4.00 | $10.00 |
| Claude Opus 5.5 | $4.00 | $0.20 | $5.00 / $8.00 | $20.00 |
단위는 100만 토큰당 미국 달러입니다. Claude 쓰기 칸은 각각 5분·1시간 보존 옵션입니다. 지역·처리 모드·긴 문맥 등 별도 조건은 제외했습니다. 출처: OpenAI 요금표, Claude 캐싱 문서.
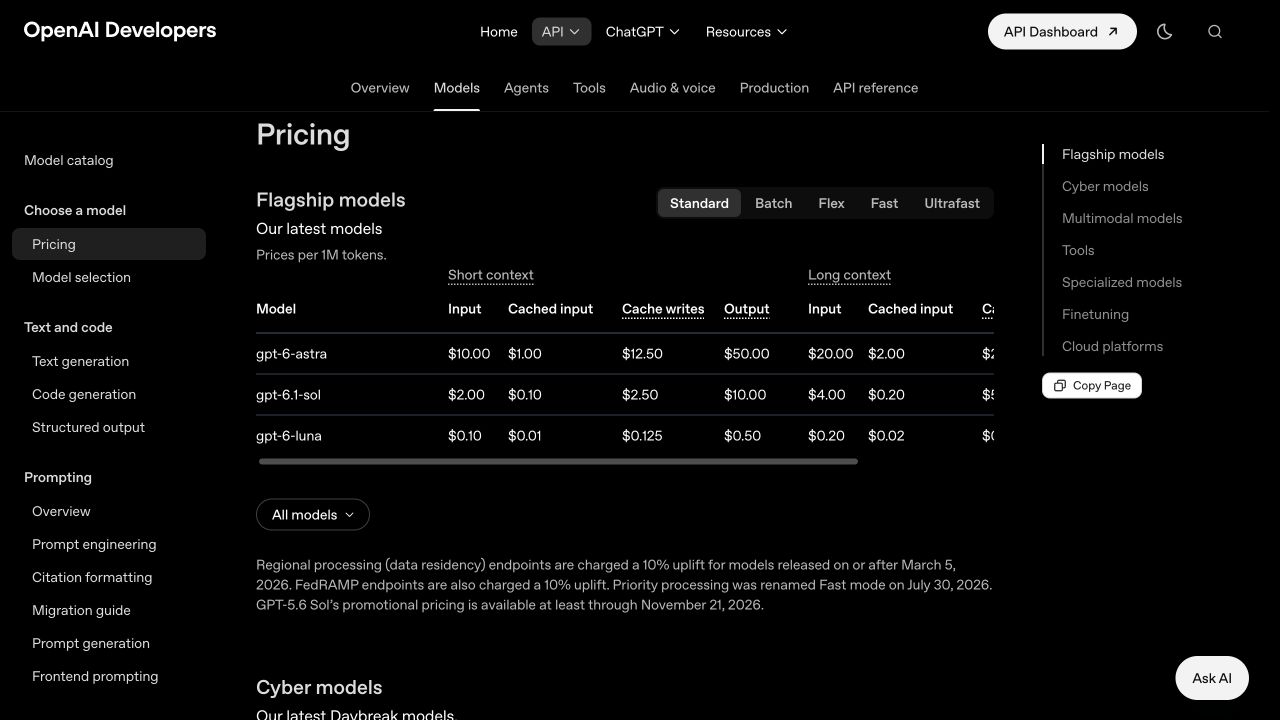
▲ OpenAI 공식 가격표, 2026년 9월 30일 캡처. Standard의 짧은 문맥 구간과 다른 조건을 섞어 계산하지 않습니다.
95% 할인인데 왜 전체 비용은 다르게 줄어드나요?
GPT-6.1 Sol의 기본 입력 $2와 캐시 읽기 $0.10을 비교하면 단가 차이는 95%입니다. 하지만 매 요청마다 새로 쓰는 질문과 출력까지 95% 할인되는 것은 아닙니다.
예를 들어 캐시 입력에서 $10을 아껴도 출력에 $90이 들었다면 전체 비용 감소는 훨씬 작습니다. 모델마다 출력 길이가 달라지는 작업에서는 단가보다 ‘완료한 작업 하나의 총비용’을 비교하는 편이 정확합니다.
세계관 2만 토큰을 1,000번 재사용한다면
GPT-6.1 Sol로 같은 세계관 20,000토큰을 한 번 쓰고, 이후 999번 모두 캐시를 읽는 가상 시나리오를 계산했습니다. 그 사이에 캐시가 만료되거나 변경되지 않고, 고정 부분 전체가 적중한다고 가정합니다.
| 계산 항목 | 계산식 | 금액 |
| 캐시 없이 고정 부분 반복 | 20,000 × 1,000 ÷ 1,000,000 × $2 | $40.000 |
| 최초 쓰기 1회 | 20,000 ÷ 1,000,000 × $2.50 | $0.050 |
| 캐시 읽기 999회 | 20,000 × 999 ÷ 1,000,000 × $0.10 | $1.998 |
| 캐시 적용 후 고정 부분 합계 | $0.050 + $1.998 | $2.048 |
고정 부분만 보면 94.88% 줄어듭니다. 여기에 매번 새 입력 500토큰과 출력 1,000토큰이 붙는다고 가정하면, 1,000회 기준 새 입력 $1과 출력 $10을 더합니다.
이 단순 비교에서 전체는 $51 → $13.048, 약 74.4% 감소입니다. 이는 직접 측정한 성능·청구액이 아닌 설명용 계산이며, 재시도·도구 요금·추가 문맥은 포함하지 않았습니다.
프롬프트는 고정 부분과 변하는 부분을 나누세요
공통 규칙, 도구 정의, 자주 참고하는 자료는 앞쪽에 안정적으로 배치하고 요청마다 달라지는 질문은 뒤에 둡니다. 앞부분의 불필요한 수정이 줄면 재사용 기회를 높일 수 있습니다.
다만 캐시를 유지하려고 오래된 규칙이나 잘못된 자료를 그대로 남겨서는 안 됩니다. 정확성이 먼저이고, 자료를 수정했다면 새 버전으로 구분해 쓰기 비용과 읽기 비율을 다시 확인합니다.
실무에서는 다음처럼 구성할 수 있습니다.
- 공통 지침과 자료에 버전을 붙입니다.
- 사용자별·요청별 내용은 뒤에서 전달합니다.
- 모델과 설정을 기록하고 한 조건씩 변경합니다.
- 응답의 사용량으로 실제 읽기·쓰기 양을 확인합니다.
유지 시간과 최소 길이는 모델별입니다
OpenAI 문서에서 GPT-5.6 이후 모델의 기본 최소 캐시 길이는 보이는 입력 1,024토큰이고, 캐시 수명 설정은 기본 30분입니다. 같은 앞부분을 보냈다는 이유만으로 모든 요청의 적중을 보장할 수는 없습니다. 공식 캐싱 가이드를 해당 모델 기준으로 확인하세요.
Claude는 선택한 모델에 따라 최소 길이가 다르고 기본 5분 또는 추가 비용이 있는 1시간 옵션을 사용합니다. ‘최신 모델은 모두 같은 최소 길이’라고 뭉뚱그리기보다 모델명이 적힌 문서 표를 확인합니다.
적용 전후에는 무엇을 기록하나요?
속도나 적중률 하나만 보지 말고 같은 작업의 정답률과 완료 비용을 함께 봅니다. 아래는 실제 값을 채워 넣기 위한 기록표입니다.
| 기록 항목 | 확인할 내용 |
| 비교 조건 | 모델명·처리 모드·자료 버전·호출 간격 |
| 캐시 사용량 | 읽기 토큰·쓰기 토큰·일반 입력 토큰 |
| 작업 결과 | 정답 여부·재시도·완료까지 걸린 시간 |
| 총비용 | 입력·캐시·출력·도구 요금 합산 |
실패한 요청을 빼고 성공 사례만 비교하면 절감 효과가 과장됩니다. 같은 테스트 묶음을 반복하고, 작업 하나를 끝내는 데 든 재시도도 포함합니다.
자주 묻는 질문
첫 요청부터 할인받나요?
처음 캐시를 만드는 요청과 이후 재사용 요청은 구분해야 합니다. 위 계산도 첫 쓰기 1회와 읽기 999회를 따로 계산했습니다.
캐시를 위해 문장을 길게 늘리면 이득인가요?
불필요한 문맥을 추가하면 쓰기 비용과 관리 부담도 커집니다. 먼저 반복해서 필요한 자료가 있는지 확인하고 총비용으로 판단하세요.
프롬프트가 같으면 답도 같아지나요?
프롬프트 캐싱을 응답 완성본 저장과 혼동하면 안 됩니다. 여기서 비교하는 것은 입력 처리의 재사용이며, 작업 결과 검증은 별도로 필요합니다.
적용할 때와 미뤄도 될 때
긴 지침과 자료를 여러 요청에서 반복한다면 캐싱을 점검할 가치가 큽니다. 반대로 짧고 매번 다른 질문이 대부분이면 입력 길이와 출력·재시도 비용부터 줄이는 편이 나을 수 있습니다.
함께 읽기: AI 게임의 서버 비용 사례, 코딩 에이전트 비용을 보는 관점.
출처와 수정일
- OpenAI Prompt caching
- OpenAI API Pricing
- Claude Prompt caching
- 모두 2026-09-30 확인. 기존 글의 전체 비용처럼 읽히는 할인 표현, 첫 쓰기 비용 누락, 모델별 조건의 일반화를 수정했습니다. 이전 계산 이미지 대신 현재 공식 표와 새 계산표를 사용했습니다.