OpenAI가 공개한 표에서는 GPT-6 아스트라가 클로드 페이블 5.1을 15대2로 앞섭니다. 앤트로픽이 공개한 표에서는 클로드 오퍼스 5.5가 아스트라를 4대2로 앞섭니다.
두 표 모두 각 회사 공식 발표에 실린 숫자이고, 결과가 갈린 이유는 누구와 비교했느냐에 있습니다.
한눈에 보기
- OpenAI 표(9월 3일): 아스트라 vs 페이블 5.1, 공통 벤치마크 17개 중 아스트라 15개 우세
- 앤트로픽 표(9월 22일): 오퍼스 5.5 vs 아스트라, 공통 6개 중 오퍼스 5.5 4개 우세
- 독립 평가 Artificial Analysis(9월 28일): 오퍼스 5.5 58점, 아스트라와 페이블 5.1 53점
GPT-6 아스트라와 클로드, 언제 무엇이 나왔나요?
한 달 사이에 두 회사가 번갈아 새 모델을 냈습니다. 비교표의 상대가 서로 다른 것도 이 순서 때문입니다.
| 날짜 | 회사 | 모델 | API 가격 (100만 토큰당 입력 / 출력) |
|---|---|---|---|
| 9월 1일 | 앤트로픽 | 클로드 페이블 5.1 | $10 / $50 |
| 9월 3일 | OpenAI | GPT-6 아스트라 | $10 / $50 |
| 9월 22일 | 앤트로픽 | 클로드 오퍼스 5.5 | $4 / $20 |
| 9월 22일 | OpenAI | GPT-6 Sol, Luna | $2 / $10, $0.10 / $0.50 |
OpenAI 표에서는 왜 아스트라가 15대2인가요?
아스트라가 나올 때 앤트로픽의 최상위 모델은 페이블 5.1이었습니다. OpenAI 표에서 두 모델 점수가 모두 있는 벤치마크는 17개이고, 그중 15개에서 아스트라가 앞섭니다.
격차가 큰 쪽은 수학(FrontierMath Tier 4, 97.6% 대 87.8%)과 과학 에이전트(Terminal-Bench Science, 64.6% 대 52.6%), 업무 자동화(AutomationBench, 41.4% 대 31.4%)입니다.
페이블 5.1이 앞선 2개는 Artificial Analysis 지능 지수(65.7 대 61.2)와 Humanity’s Last Exam 도구 사용(65.0% 대 57.2%)입니다. OpenAI가 직접 만든 표에 실린 숫자입니다.
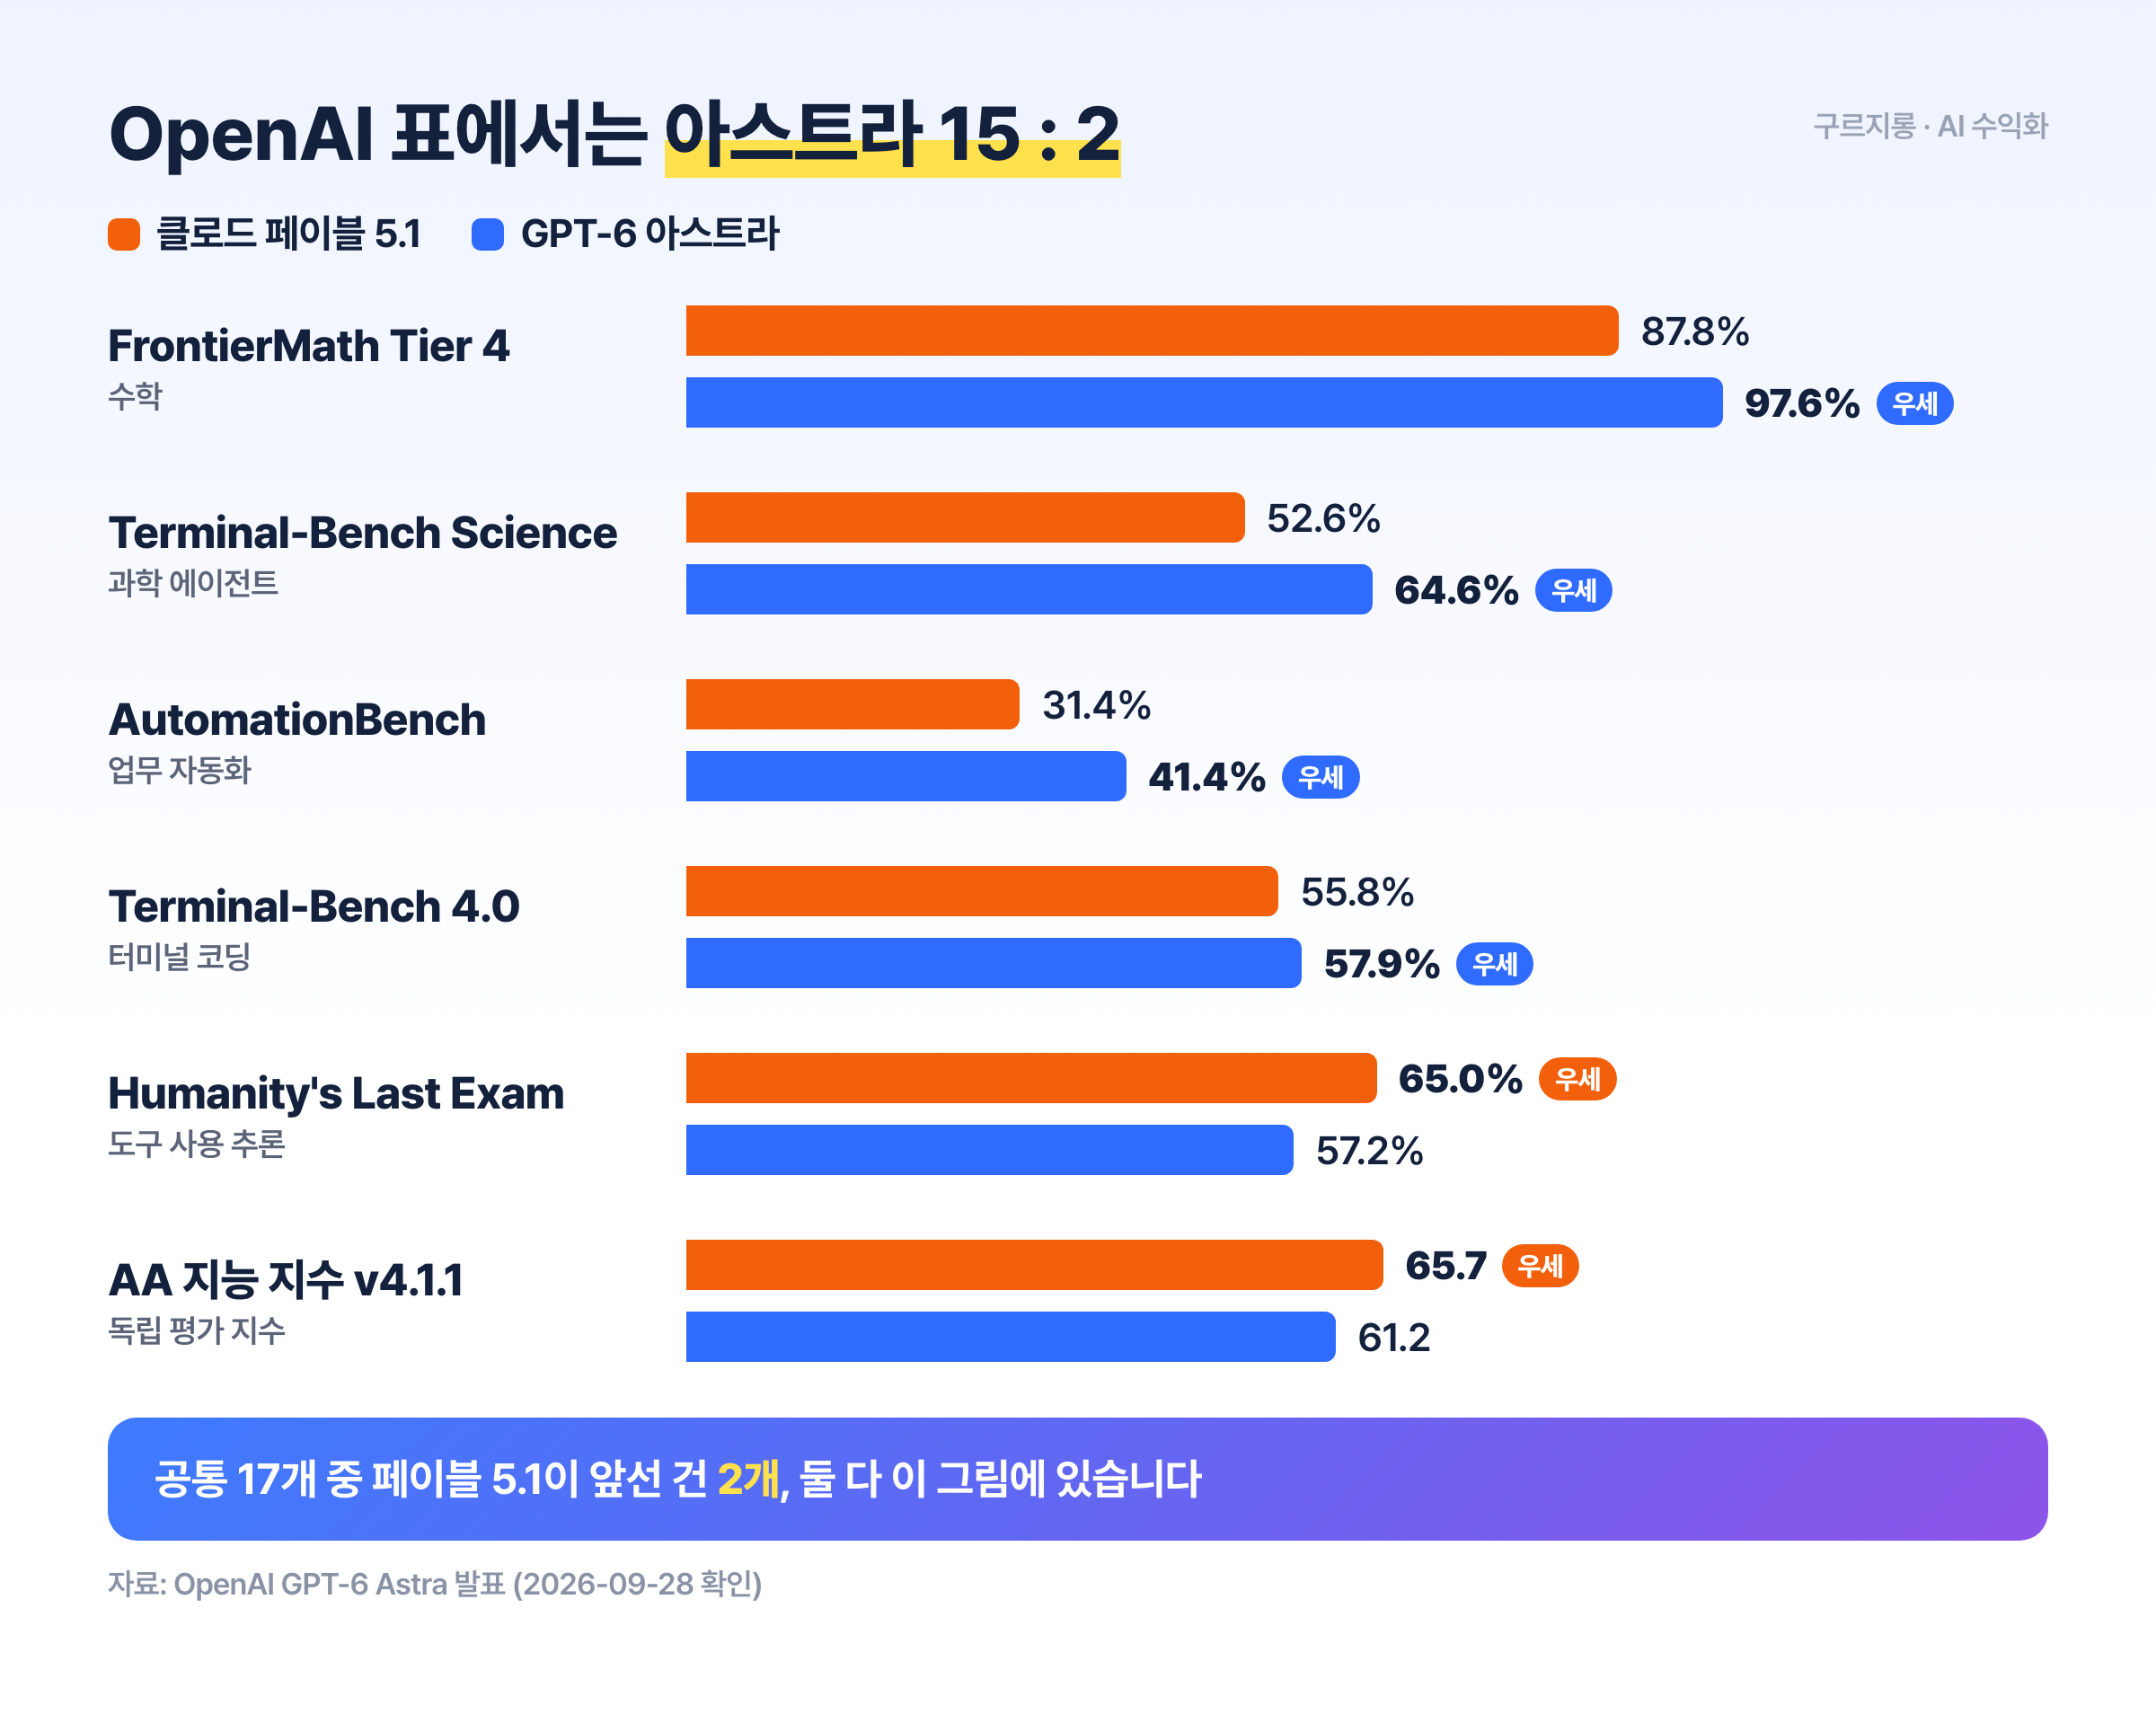
▲ OpenAI 발표 표 기준, 아스트라와 페이블 5.1의 주요 벤치마크 비교
앤트로픽 표에서는 왜 오퍼스 5.5가 4대2인가요?
앤트로픽은 9월 22일 오퍼스 5.5를 내면서 아스트라를 비교 대상에 넣었습니다. 두 모델 점수가 모두 있는 6개 중 4개에서 오퍼스 5.5가 앞섭니다.
터미널 코딩(Terminal-Bench 4.0, 66.4% 대 57.9%)과 지식 업무(GDPval-AA, 1846 대 1542 Elo)에서 차이가 가장 큽니다. 업무 자동화(41.4% 대 40.0%)와 과학 에이전트(64.6% 대 58.7%)는 아스트라가 앞섭니다.
앤트로픽은 아스트라 점수를 OpenAI 발표와 Zapier 공개 순위표에서 가져왔다고 각주에 적었습니다. 같은 글에서 이 정도 성능에서는 벤치마크 격차가 실제 차이를 잘 보여 주지 못한다고도 썼습니다.
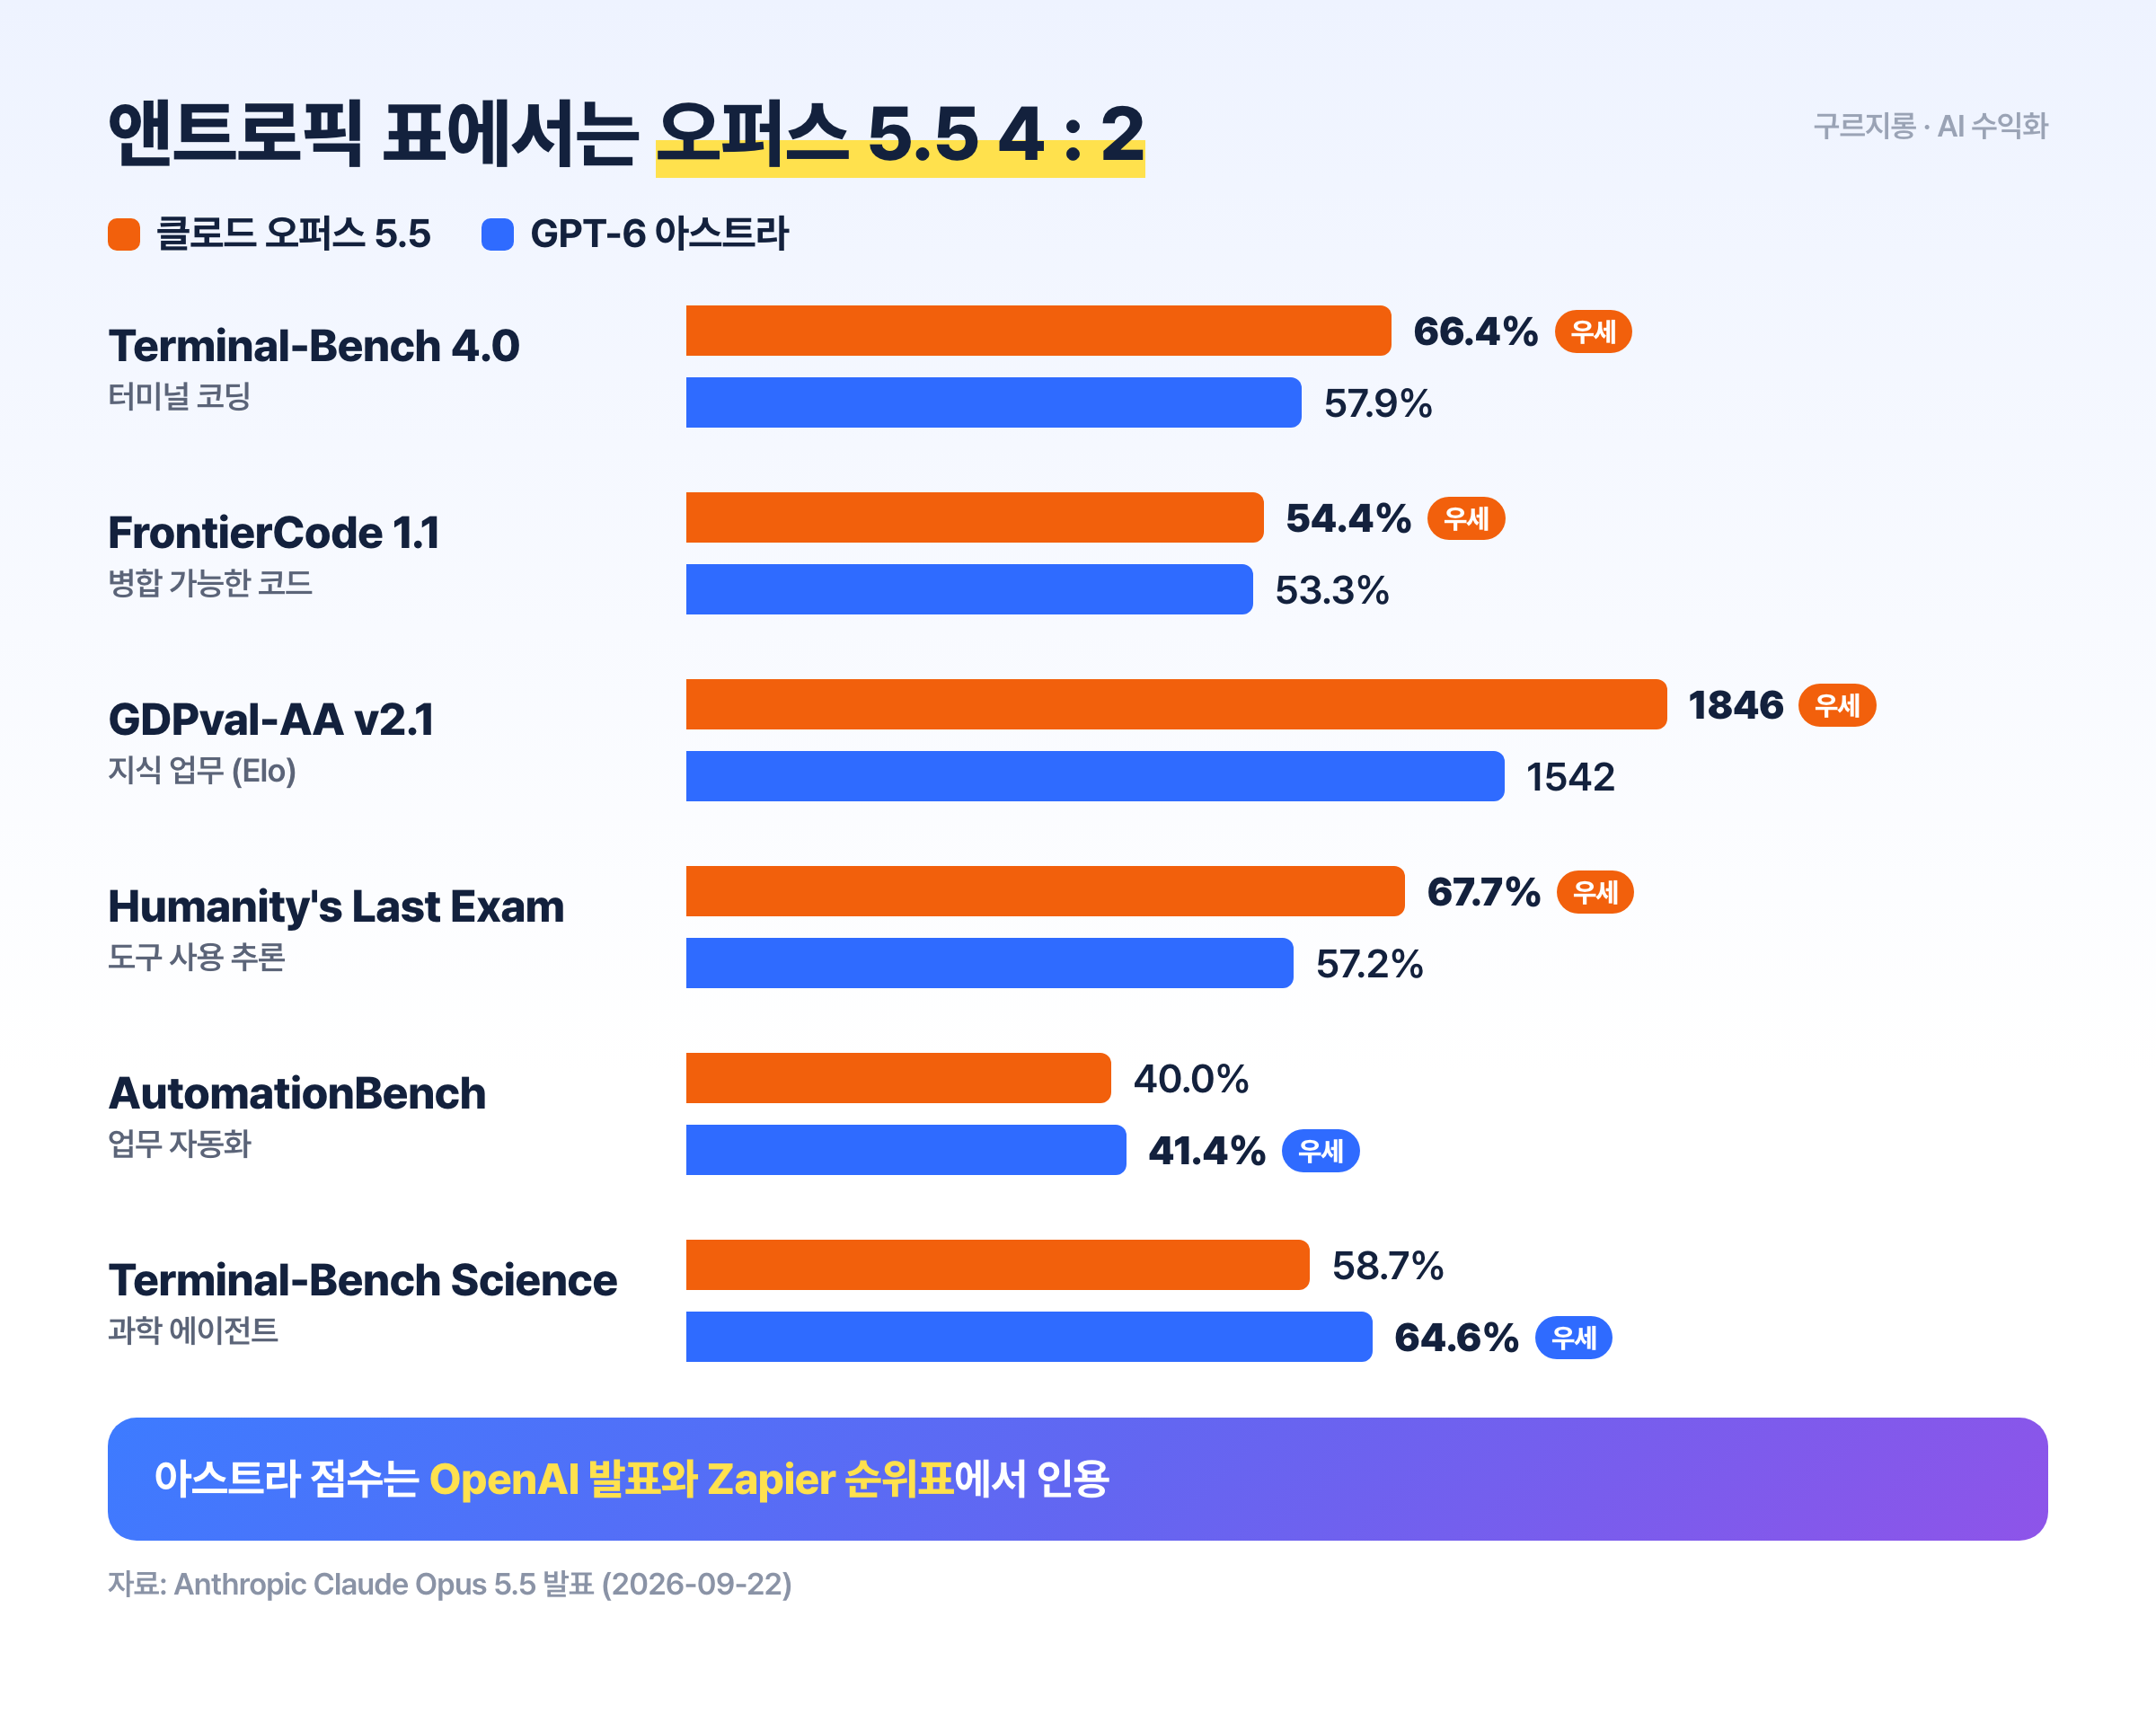
▲ 앤트로픽 발표 표 기준, 오퍼스 5.5와 아스트라의 공통 벤치마크 6개
두 회사 표를 한 번에 보면 어떤가요?
| 벤치마크 (분야) | 클로드 | GPT-6 아스트라 | 발표 |
|---|---|---|---|
| Terminal-Bench 4.0 (터미널 코딩) | 66.4% (오퍼스 5.5) | 57.9% | 앤트로픽 |
| GDPval-AA v2.1 (지식 업무) | 1846 (오퍼스 5.5) | 1542 | 앤트로픽 |
| Humanity’s Last Exam (도구 사용) | 67.7% (오퍼스 5.5) | 57.2% | 앤트로픽 |
| AutomationBench (업무 자동화) | 40.0% (오퍼스 5.5) | 41.4% | 앤트로픽 |
| FrontierMath Tier 4 (수학) | 87.8% (페이블 5.1) | 97.6% | OpenAI |
| GPQA Diamond (과학 지식) | 93.7% (페이블 5.1) | 96.0% | OpenAI |
| ARC-AGI-3 (추상 추론) | 30.2% (오퍼스 5) | 99.9% | OpenAI |
코딩과 지식 업무는 클로드, 수학과 과학, 추상 추론은 아스트라 쪽 숫자가 높습니다. ARC-AGI-3는 한 세대 전 모델인 오퍼스 5와 비교한 값입니다.
독립 평가 순위에서는 누가 앞서나요?
Artificial Analysis는 여러 모델을 같은 방식으로 평가해 지능 지수를 냅니다. 9월 28일 순위표 1위는 클로드 오퍼스 5.5(max) 58점입니다.
GPT-6 아스트라(max)와 클로드 페이블 5.1(max)은 53점으로 같고, GPT-6 Sol(max)은 48점입니다. 클로드 점수는 안전장치가 개입하면 다른 클로드 모델이 대신 답하는 설정(with fallback)으로 측정됐습니다.
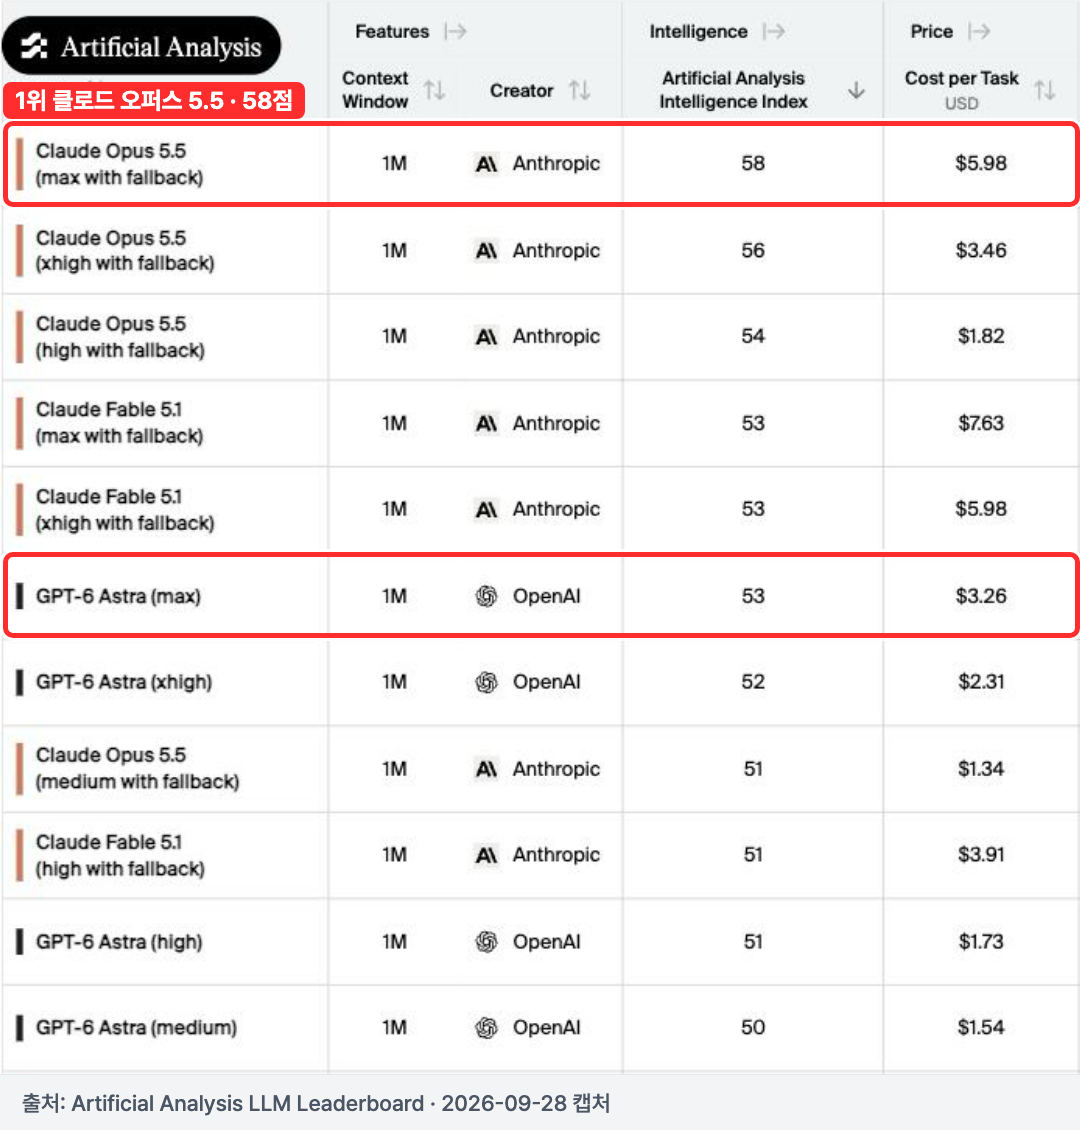
▲ 출처: Artificial Analysis 모델 순위표, 지능 지수와 작업당 비용
토큰값이 2.5배 싸면 작업당 비용도 쌀까요?
토큰값만 보면 오퍼스 5.5는 입력 $4, 출력 $20으로 아스트라의 40%입니다. 그런데 같은 순위표의 작업당 비용은 최고 추론 설정(max)에서 오퍼스 5.5 $5.98, 아스트라 $3.26으로 뒤집힙니다.
생각을 길게 하는 설정일수록 토큰을 많이 쓰기 때문입니다. 반대로 오퍼스 5.5를 한 단계 낮춘 high 설정은 54점에 $1.82로, 아스트라 max보다 점수는 높고 비용은 낮습니다.
| 모델 (추론 설정) | 지능 지수 | 작업당 비용 |
|---|---|---|
| 클로드 오퍼스 5.5 (max) | 58 | $5.98 |
| 클로드 오퍼스 5.5 (high) | 54 | $1.82 |
| 클로드 페이블 5.1 (max) | 53 | $7.63 |
| GPT-6 아스트라 (max) | 53 | $3.26 |
| GPT-6 아스트라 (high) | 51 | $1.73 |
| GPT-6 Sol (max) | 48 | $1.06 |
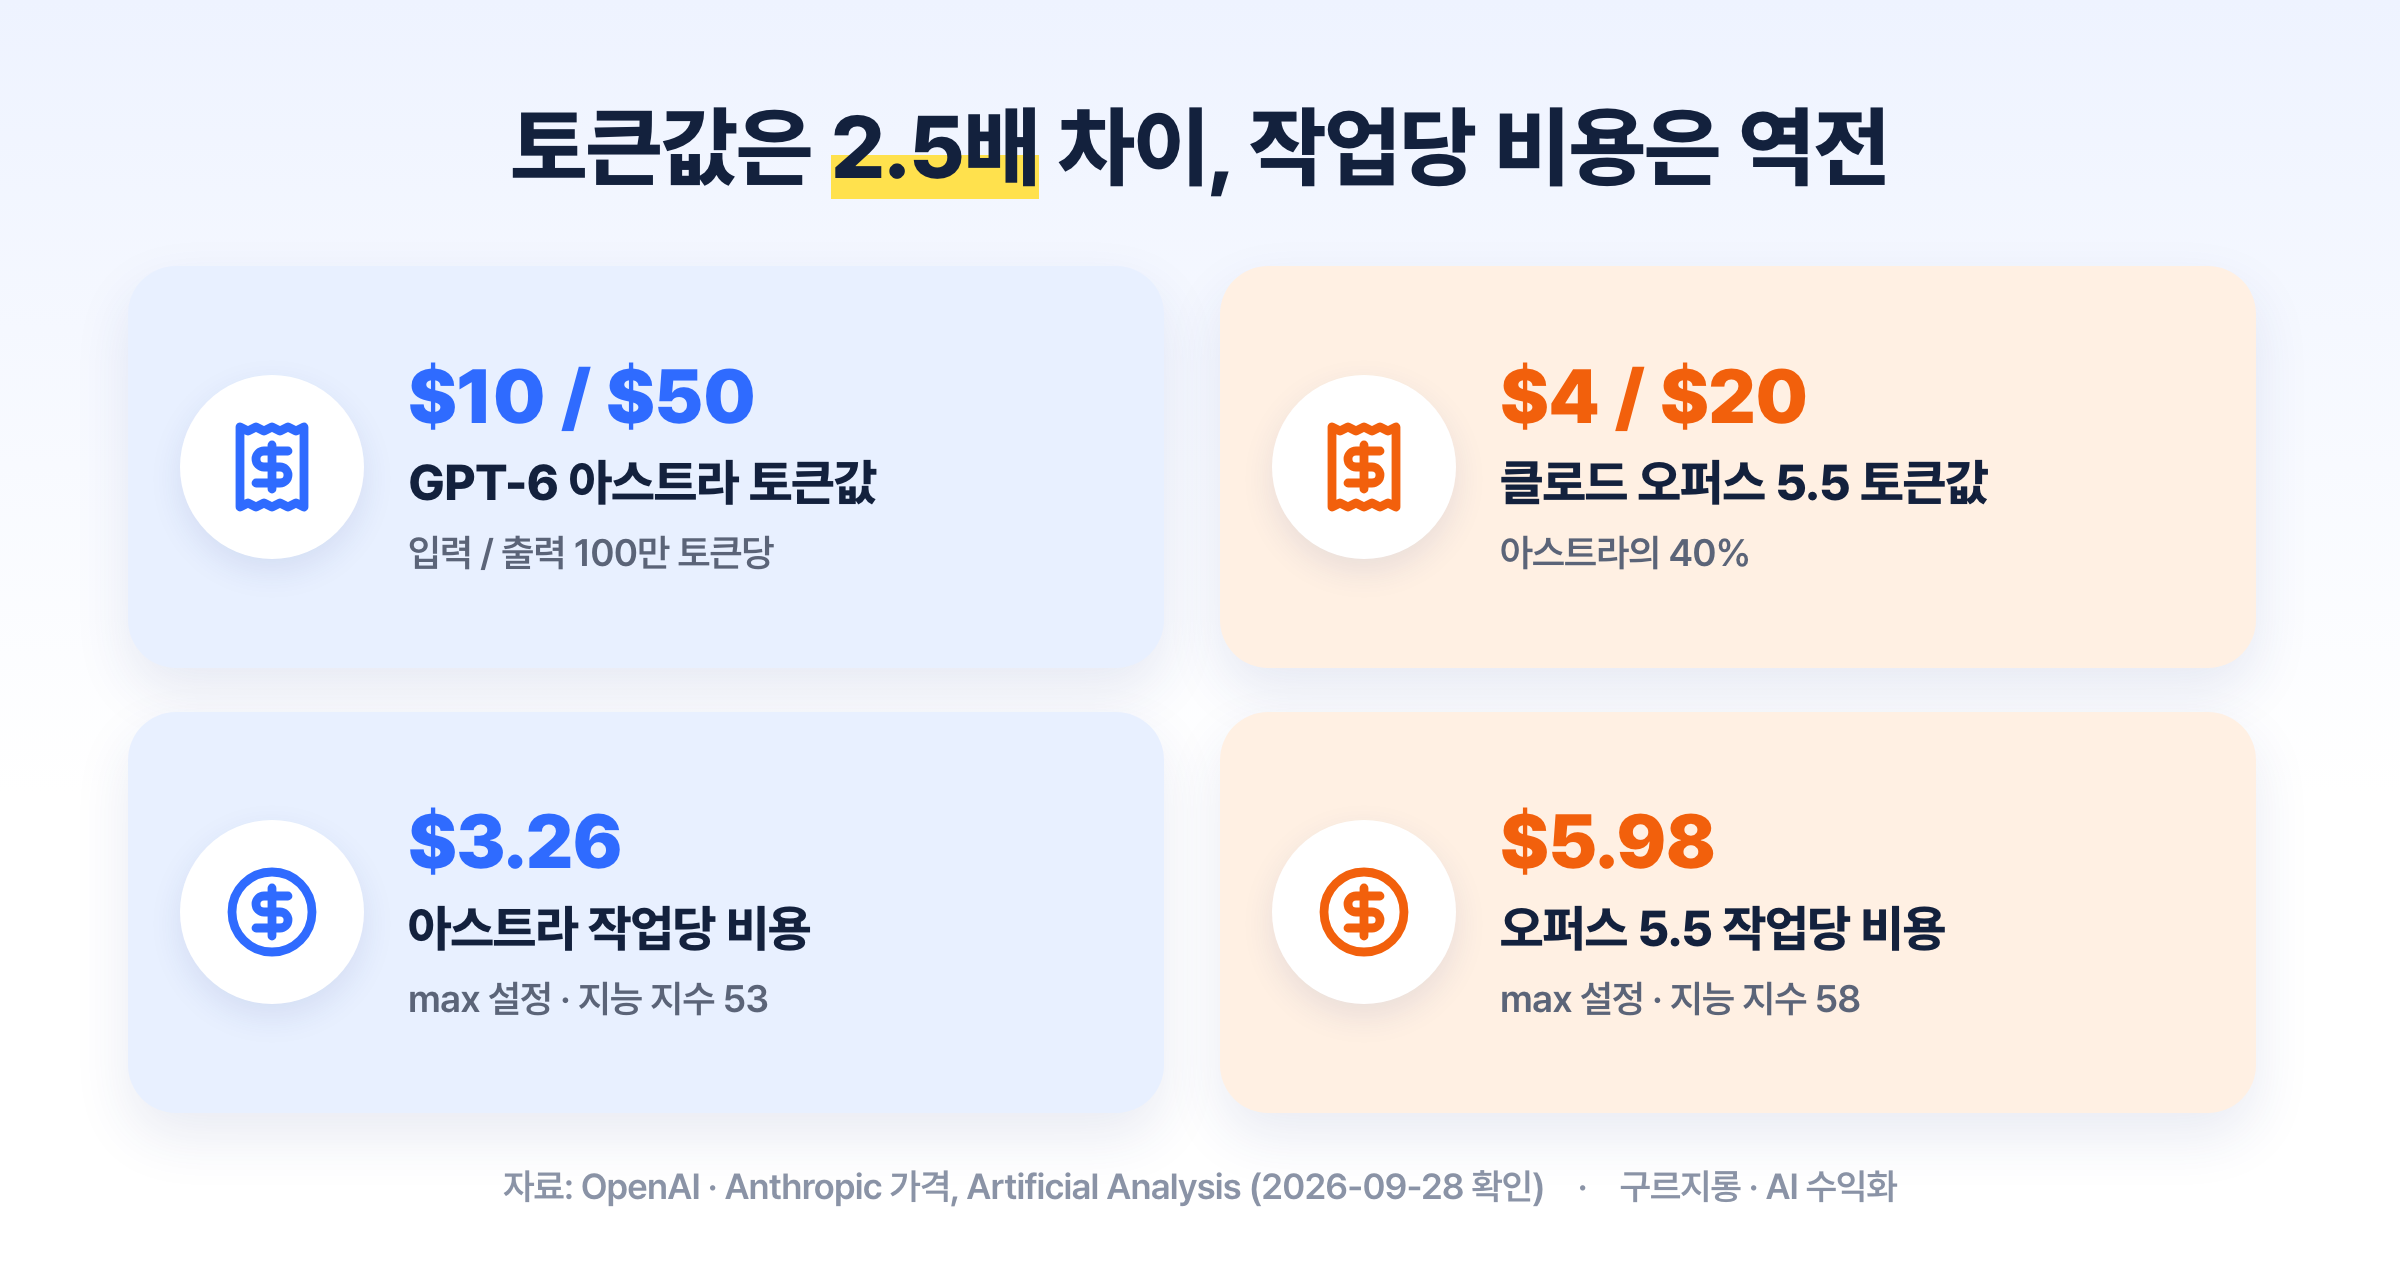
▲ 토큰값은 오퍼스 5.5가 싸지만, 최고 설정의 작업당 비용은 아스트라가 낮습니다
같은 날 나온 GPT-6 Sol은 누구와 비교했나요?
OpenAI는 오퍼스 5.5가 나온 9월 22일에 GPT-6 Sol과 Luna를 공개했습니다. 이 발표의 비교 대상은 오퍼스 5와 페이블 5.1이었고, 같은 날 나온 오퍼스 5.5는 들어 있지 않습니다.
앤트로픽의 오퍼스 5.5 표에도 GPT-6 Sol이 아니라 이전 세대 GPT-5.6 Sol이 들어 있습니다. 두 회사 모두 발표 시점에 나와 있던 상대 모델과 비교한 셈입니다.
게임 개발자는 어떻게 골라야 하나요?
OpenAI는 아스트라 발표에서 카트 레이싱 게임과 Unreal Engine 작업 예시를 보여 줬고, 앤트로픽은 실제 Cursor 작업으로 만든 CursorBench 점수를 앞세웠습니다. 둘 다 게임 코드에 쓸 수 있지만, 순위는 종목과 설정에 따라 바뀝니다.
- 최근 실제 작업 10개 고르기: 버그 수정, 에디터 스크립트, UI 수정처럼 평소 맡기는 일로 고릅니다.
- 같은 도구와 프롬프트로 돌리기: 같은 코딩 에이전트에서 모델만 바꿉니다.
- 성공률과 작업당 비용 기록: 토큰 단가가 아니라 작업 하나를 끝내는 데 든 금액을 봅니다.
- 추론 설정을 두 단계 이상 비교: high와 max처럼 설정을 바꾸면 점수와 비용 순서가 달라질 수 있습니다.
자주 묻는 질문
GPT-6 아스트라와 클로드 오퍼스 5.5 중 어느 쪽이 더 똑똑한가요?
독립 평가인 Artificial Analysis 지능 지수에서는 오퍼스 5.5가 58점으로 아스트라(53점)보다 높습니다(2026년 9월 28일 기준). 수학과 과학 벤치마크에서는 아스트라 점수가 더 높습니다.
두 모델 API 가격은 얼마인가요?
100만 토큰당 GPT-6 아스트라는 입력 $10, 출력 $50이고 클로드 오퍼스 5.5는 입력 $4, 출력 $20입니다. 추론 설정에 따라 쓰는 토큰 양이 달라지니 작업당 비용으로 비교해야 합니다.
회사가 발표한 벤치마크는 믿어도 되나요?
숫자 자체는 공개된 방법으로 잰 값이지만, 어떤 종목과 상대를 넣을지는 발표하는 회사가 정합니다. 각주의 추론 설정과 상대 점수 출처를 확인하고 독립 평가와 함께 보는 편이 좋습니다.
정리
OpenAI 표에서는 아스트라가, 앤트로픽 표에서는 오퍼스 5.5가 이깁니다. 독립 평가 지능 지수는 현재 오퍼스 5.5가 앞서고, 최고 설정의 작업당 비용은 아스트라가 낮습니다.
어느 쪽이 1위인지는 종목과 설정에 따라 달라지니, 내 작업 10개로 직접 돌려 보는 것이 가장 정확합니다.
함께 보면 좋은 글
- GPT-6 Astra 게임 프로토타이핑, 수동 수정 50% 줄인 Playco 사례 정리: https://gony0916.tistory.com/17
- Steam AI 게임 1인 개발, AI Roguelite가 LLM 비용을 나눈 3단 구조: https://gony0916.tistory.com/20
- AI 게임 서버 비용, AI Dungeon이 며칠 만에 $20,000 요금을 받은 이유: https://gony0916.tistory.com/21
출처와 확인일
- OpenAI, GPT-6 Astra 발표 (2026-09-28 확인): https://openai.com/index/gpt-6-astra/
- OpenAI, GPT-6 Sol과 Luna 소개 (2026-09-22 발표, 2026-09-28 확인): https://openai.com/index/introducing-gpt-6-sol-and-luna
- Anthropic, Claude Opus 5.5 (2026-09-22 발표, 2026-09-28 확인): https://www.anthropic.com/claude-opus-5-5
- Anthropic, Claude Fable 5.1 and Claude Mythos 5.1 (2026-09-28 확인): https://www.anthropic.com/claude-fable-and-mythos-5-1
- Artificial Analysis, LLM Leaderboard (2026-09-28 확인): https://artificialanalysis.ai/leaderboards/models