IT기술 · AI 모델·도구 | TechPulse 편집 | 자료 확인·작성: 2026년 10월 16일 한국시간
코딩용 AI를 고를 때는 종합 1위보다 내가 맡길 작업과 비슷한 평가를 먼저 봐야 합니다. Gemini 4 Argon이 포함된 최신 비교표에서도 저장소 수정·터미널 작업에 따라 선두가 바뀝니다. 이 글은 점수를 더해 승자를 정하지 않고, 평가 조건과 내 프로젝트용 시험표를 함께 제공합니다.
같은 코딩 평가인데 왜 결과가 갈릴까?
코딩은 하나의 행동이 아닙니다. 기존 저장소를 읽고 버그를 고치는 일, 셸 도구를 조합해 환경을 복구하는 일, 화면이 있는 결과물을 만드는 일은 실패 원인이 다릅니다. 특정 시험의 성공률을 다른 업무의 예상 성공률로 옮겨 적으면 모델 선택이 어긋납니다.
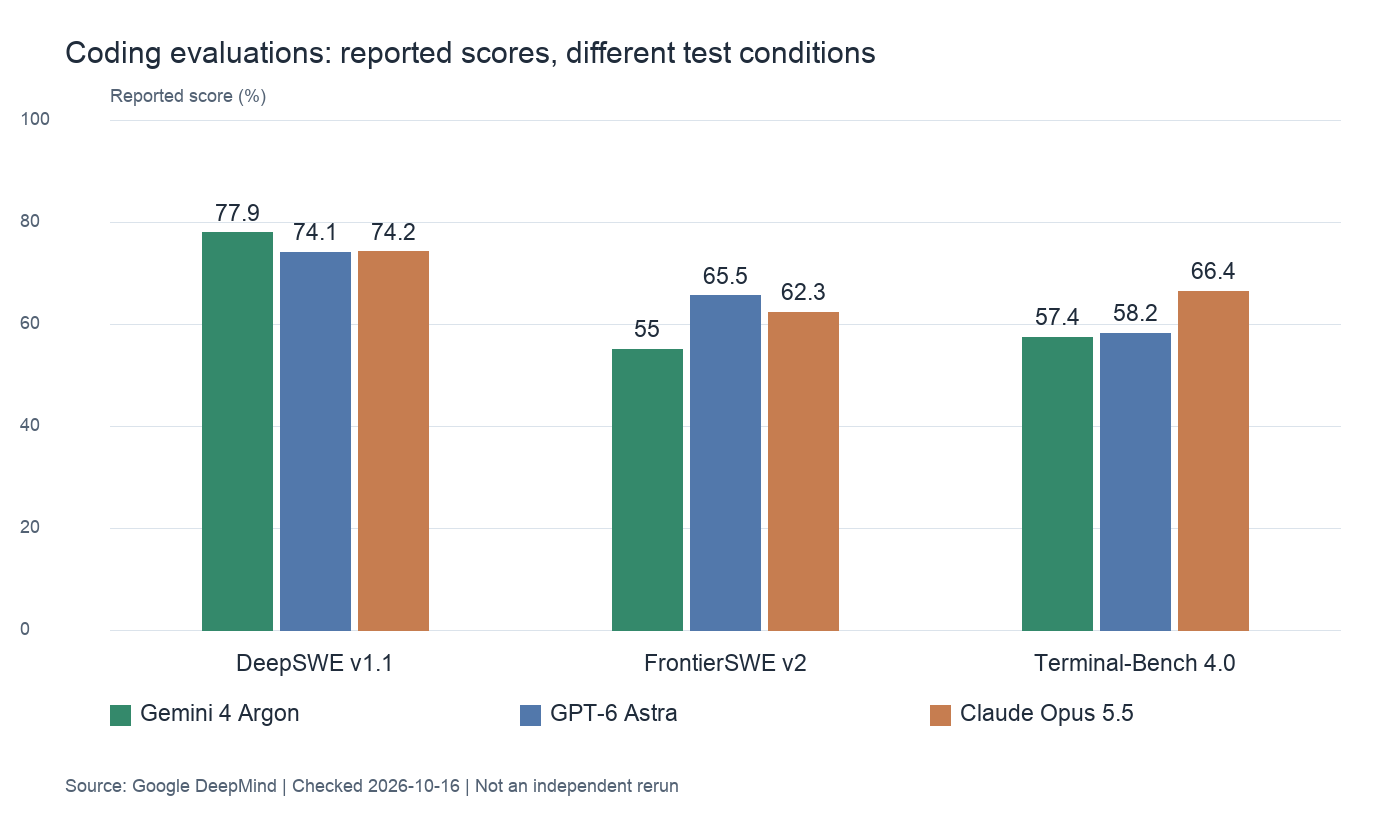
아래 수치는 2026년 10월 16일 확인한 Google DeepMind 비교표에서 가져왔습니다. 서로 다른 발표에서 유리한 숫자만 합치지 않았습니다. DeepMind 공식 모델 비교표
| 평가 | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| DeepSWE v1.1 | 77.9% | 74.1% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 62.3% |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 66.4% |
이 표는 세 모델을 한 실험실에서 다시 잰 결과일까?
전부 그렇지는 않습니다. DeepMind는 Argon의 일부 점수를 직접 측정하고, 다른 모델은 공식 순위표·시스템 카드에서 가져왔다고 밝힙니다. DeepSWE의 Argon 실행에는 mini-swe 에이전트가 쓰였고, Terminal-Bench 역시 모델별 출처와 추론 설정을 확인해야 합니다. DeepMind Argon 평가 방법 PDF
따라서 이 표에서 말할 수 있는 것은 “각 평가의 보고된 조건에서 순서가 다르다”까지입니다. 소수점 차이를 내 프로젝트의 확정적 우위로 해석할 근거는 부족합니다. 특히 API 모델과 코딩 에이전트의 조합이 다르면 파일 탐색·오류 복구 방식도 달라질 수 있습니다.
내 저장소에서는 이렇게 비교해 보자
다음은 편집부가 제안하는 소규모 도입 시험입니다. 직접 실행한 결과가 아니며, 업체 전체 성능을 대표하는 표본도 아닙니다. 실제 최근 작업에서 비슷한 난도의 문제를 골라 같은 시작 커밋과 실행 환경을 사용합니다.
| 업무 | 성공 기준을 먼저 적기 | 함께 기록할 값 |
|---|---|---|
| 버그 수정 | 재현 테스트 통과, 기존 테스트 유지 | 수동 수정 횟수·전체 비용 |
| 리팩터링 | 동작 유지, 변경 범위 준수 | 의도 밖 파일 변경·검토 시간 |
| 환경 복구 | 새 환경에서 같은 명령으로 재현 | 설치 시간·외부 도구 의존성 |
| 작은 UI 구현 | 요구한 조작과 화면 확인 | 접근성·모바일 오류·수정 시간 |
점수보다 먼저 정할 중단 기준
- 성공 기준을 본 뒤 유리하게 바꾸지 않습니다.
- 실패한 실행도 분모와 비용에 포함합니다.
- 모델·추론 설정·에이전트 버전·도구 권한을 함께 적습니다.
- 테스트는 통과했어도 요구사항을 빠뜨렸다면 부분 성공으로 분리합니다.
예를 들어 테스트를 통과한 두 후보 중 하나가 무관한 파일까지 고쳤다면, 병합 전 검토 부담은 다릅니다. 반대로 한 번의 프롬프트로 실패했더라도 적은 수정으로 끝나는 후보가 실제 업무에서는 유리할 수 있습니다. 이 판단을 하려면 완료까지의 시간과 사람의 수정량이 필요합니다.
이번 비교에서 내릴 수 있는 결론
Argon을 포함한 최신 표는 “코딩 성능”이라는 말이 너무 넓다는 것을 보여 줍니다. 저장소 수정이 목적이면 관련 평가부터 보고, 터미널 운영이 목적이면 해당 평가를 따로 확인하세요. 최종 선택은 같은 도구·같은 과제에서의 성공률과 검토 부담으로 좁히는 편이 합리적입니다.
출처와 확인 범위
- DeepMind 공식 모델 비교표 · 2026-10-16 확인
- DeepMind Argon 평가 방법 PDF · 2026-10-16 확인
- OpenAI GPT-6 Astra 공식 사양 · 2026-10-16 확인
- Anthropic Opus 5.5 발표·가격 · 2026-10-16 확인
공식 사양·업체 평가·독립 평가를 구분해 직접 정리했습니다. 계산과 점검 양식은 본문에 표시한 가정 또는 편집 제안입니다. 자체 모델 실행 결과로 제시하지 않았으며 가격·제공 범위·순위는 이후 바뀔 수 있습니다.
답글 남기기